
اگر فایل robots.txt قدیمی سایتتان را برای گوگل تنظیم کردهاید، احتمالاً نسبت به ربات های هوش مصنوعی که همین حالا دارند سایتتان را میخزند، کاملاً بیتوجه اید. تنظیم robots.txt برای هوش مصنوعی یکی از جدیدترین و نادیدهگرفتهشدهترین بخشهای سئوی تکنیکال است. در ادامه دقیقاً میبینیم هر ربات چه کار میکند و چطور باید با آن رفتار کرد.
robots.txt یک فایل متنی ساده در ریشهی دامنه است (مثل yourdomain.com/robots.txt) که به هر ربات میگوید اجازهی خزیدن کدام بخش از سایت را دارد. برای رباتهای هوش مصنوعی، همین فایل تعیین میکند آیا محتوای شما اجازه دارد برای آموزش مدلها استفاده شود، در نتایج جستجوی هوش مصنوعی مثل ChatGPT Search دیده شود، یا اصلاً دیده نشود.
اگر هنوز با مفهوم سئو چیست آشنا نیستید، بد نیست اول همان را مرور کنید؛ چون robots.txt یکی از ابزارهای اصلی سئوی تکنیکال است. نکتهی مهم این است که robots.txt فقط یک توافق داوطلبانه است؛ رباتهای معتبر (گوگل، OpenAI، Anthropic) آن را رعایت میکنند، ولی اسکریپرهای ناشناس معمولاً به آن اهمیتی نمیدهند.
robots.txt جلوی خزیدن (Crawling) را میگیرد، یعنی به ربات میگوید اصلاً وارد صفحه نشود. اما noindex (که معمولاً در متا تگ یا هدر HTTP قرار میگیرد) جلوی ایندکس شدن را میگیرد، یعنی ربات صفحه را میبیند ولی اجازه ندارد آن را در نتایج نشان دهد. این دو ابزار کاملاً متفاوت عمل میکنند و قابل جایگزینی با هم نیستند.
نه لزوماً. اگر یک صفحه از قبل ایندکس شده و لینکهای زیادی به آن اشاره میکنند، مسدود کردن ربات در robots.txt فقط جلوی خزیدنهای بعدی را میگیرد، نه حذف فوری آن از نتایج موجود. برای حذف قطعی باید از noindex یا درخواست حذف مستقیم در ابزارهای مربوط به همان موتور جستجو استفاده کرد.
هر شرکت هوش مصنوعی، یک یا چند User-agent اختصاصی دارد که باید جداگانه در robots.txt مدیریت شوند:
| ربات | شرکت | وظیفه اصلی |
|---|---|---|
| GPTBot | OpenAI | جمعآوری داده برای آموزش مدل |
| OAI-SearchBot | OpenAI | ساخت ایندکس زنده برای ChatGPT Search |
| ChatGPT-User | OpenAI | واکشی لحظهای صفحه وقتی کاربر از ChatGPT لینک میخواهد |
| ClaudeBot / Claude-SearchBot / Claude-User | Anthropic | آموزش مدل، جستجوی زنده و واکشی لحظهای |
| PerplexityBot / Perplexity-User | Perplexity | خزیدن برای ایندکس و واکشی لحظهای |
| Google-Extended | کنترل استفاده از محتوا برای آموزش Gemini | |
| Applebot-Extended | Apple | کنترل استفاده از محتوا برای آموزش Apple Intelligence |
اشتباه رایج اینجاست که همه این رباتها را یکسان فرض میکنند، در حالی که هرکدام نقش کاملاً متفاوتی دارند. اگر میخواهید پایهی این مباحث را از اول و بهصورت اصولی یاد بگیرید، آموزش صفر تا صد سئو رایگان نقطهی شروع خوبی است.
GPTBot برای جمعآوری دادهی آموزش مدلهای OpenAI استفاده میشود؛ یعنی اگر محتوای شما را بخزد، ممکن است بخشی از دانش پایهی مدلهای بعدی GPT شود.
اما OAI-SearchBot کار کاملاً متفاوتی دارد، همان رباتی است که ایندکس زندهی ChatGPT Search را میسازد و تعیین میکند آیا صفحهی شما در پاسخهای لحظهای ChatGPT بهعنوان منبع نمایش داده میشود یا نه. بستن یکی، تأثیری روی دیگری ندارد.
بله، و این دقیقاً رایجترین و منطقیترین تنظیم برای اکثر سایتهاست. با این تنظیم، محتوای شما وارد مجموعهی آموزشی GPT نمیشود ولی همچنان میتواند در پاسخهای زندهی ChatGPT Search دیده و به شما لینک داده شود.
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
جواب قطعی «بله» یا «نه» ندارد؛ به هدف شما بستگی دارد. اگر نگران استفاده از محتوای سایت برای آموزش مدلها هستید ولی همچنان میخواهید در پاسخهای هوش مصنوعی دیده شوید، باید رباتهای آموزشی را ببندید و رباتهای جستجوی زنده را باز نگه دارید.
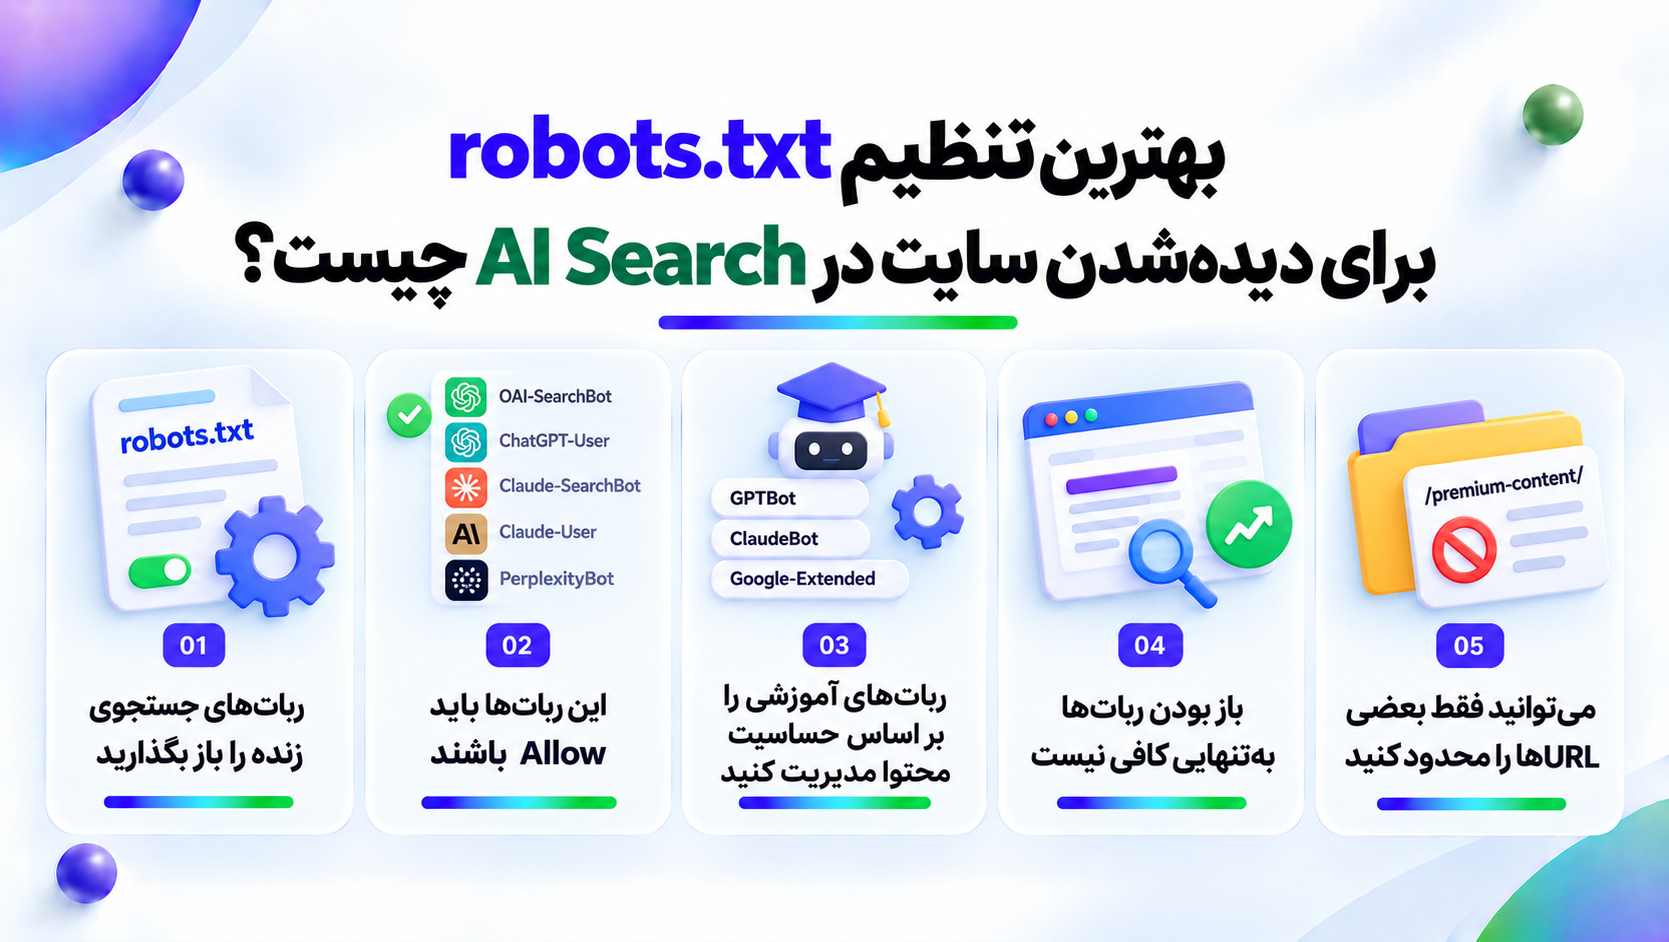
حداقل OAI-SearchBot، ChatGPT-User، Claude-SearchBot، Claude-User و PerplexityBot باید Allow باشند. اینها رباتهایی هستند که مستقیماً روی حضور شما در پاسخهای لحظهای هوش مصنوعی اثر میگذارند، نه رباتهای صرفاً آموزشی.
تصمیم دربارهی Google-Extended باید جدا از تصمیم دربارهی Googlebot گرفته شود، چون این دو کار کاملاً متفاوتی انجام میدهند.
Googlebot همان رباتی است که سایت شما را برای نتایج جستجوی عادی گوگل میخزد و ایندکس میکند؛ بستن آن یعنی حذف کامل از نتایج گوگل.
اما Google-Extended اصلاً یک ربات مستقل نیست؛ یک «سوییچ» در robots.txt است که فقط مشخص میکند آیا محتوای شما اجازه دارد برای آموزش Gemini و قابلیتهای هوش مصنوعی گوگل استفاده شود یا نه.
بستن Google-Extended هیچ تأثیری روی رتبه یا حضور شما در جستجوی عادی گوگل ندارد.
خیر، و اشتباه گرفتن این دو میتواند هزینهی سنگینی داشته باشد. بستن Googlebot یعنی حذف کامل سایت از نتایج جستجوی گوگل؛ بستن Google-Extended فقط یعنی محتوای شما برای آموزش Gemini استفاده نمیشود، بدون کوچکترین تأثیری روی رتبه یا حضور در جستجو.
برای هر ربات باید یک بلوک جداگانهی User-agent در فایل robots.txt تعریف کنید؛ ترکیب چند ربات در یک خط یا استفاده از قوانین مبهم، معمولاً باعث رفتار غیرمنتظره میشود. ساختار پایه اینطور است:
User-agent: GPTBot
Disallow: /
User-agent: OAI-SearchBot
Allow: /
User-agent: ChatGPT-User
Allow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: Google-Extended
Disallow: /
User-agent: *
Allow: /
اگر در تنظیم این بخش مطمئن نیستید، خدمات سئو میتواند این فایل را متناسب با مدل کسبوکارتان بررسی و اصلاح کند.
بهترین حالت، باز نگهداشتن رباتهای جستجوی زنده (OAI-SearchBot، ChatGPT-User، Claude-SearchBot، Claude-User، PerplexityBot) و تصمیمگیری جداگانه دربارهی رباتهای آموزشی (GPTBot، ClaudeBot، Google-Extended) بر اساس حساسیت محتواست.
OAI-SearchBot و ChatGPT-User باید Allow باشند. اگر این دو بسته باشند، صفحات شما هرگز بهعنوان منبع در پاسخهای ChatGPT نمایش داده نمیشوند، حتی اگر GPTBot را باز گذاشته باشید.
خیر. باز بودن ربات فقط شرط لازم است، نه کافی. محتوای شما همچنان باید ساختار درست، پاسخ مستقیم به سوال کاربر و اعتبار کافی داشته باشد تا مدلهای هوش مصنوعی آن را بهعنوان منبع انتخاب کنند؛ یعنی تنظیمات robots.txt باید کنار فاکتورهای محتوایی رعایت شود.
بله، و این یکی از رایجترین اشتباهات است. قانون User-agent: * برای تمام رباتهایی اعمال میشود که بلوک اختصاصی ندارند؛ پس اگر این قانون را Disallow کامل بگذارید و بلوک جداگانهای برای رباتهای هوش مصنوعی ننویسید، همهشان بهطور پیشفرض مسدود میشوند، حتی اگر قصدتان این نبوده باشد.
برای اینکه چنین خطاهایی را از همان ابتدا نسازید، دوره آموزش سئو با تمرینهای عملی روی فایلهایی مثل robots.txt میتواند کمک بزرگی باشد.
بله. robots.txt از قانونهای مسیرمحور پشتیبانی میکند، یعنی میتوانید فقط یک پوشه یا مسیر خاص (مثل /premium-content/) را برای یک ربات خاص Disallow کنید و بقیهی سایت را باز بگذارید. این دقیقترین روش برای کنترل انتخابی محتواست.
User-agent: GPTBot
Disallow: /premium-content/
Allow: /
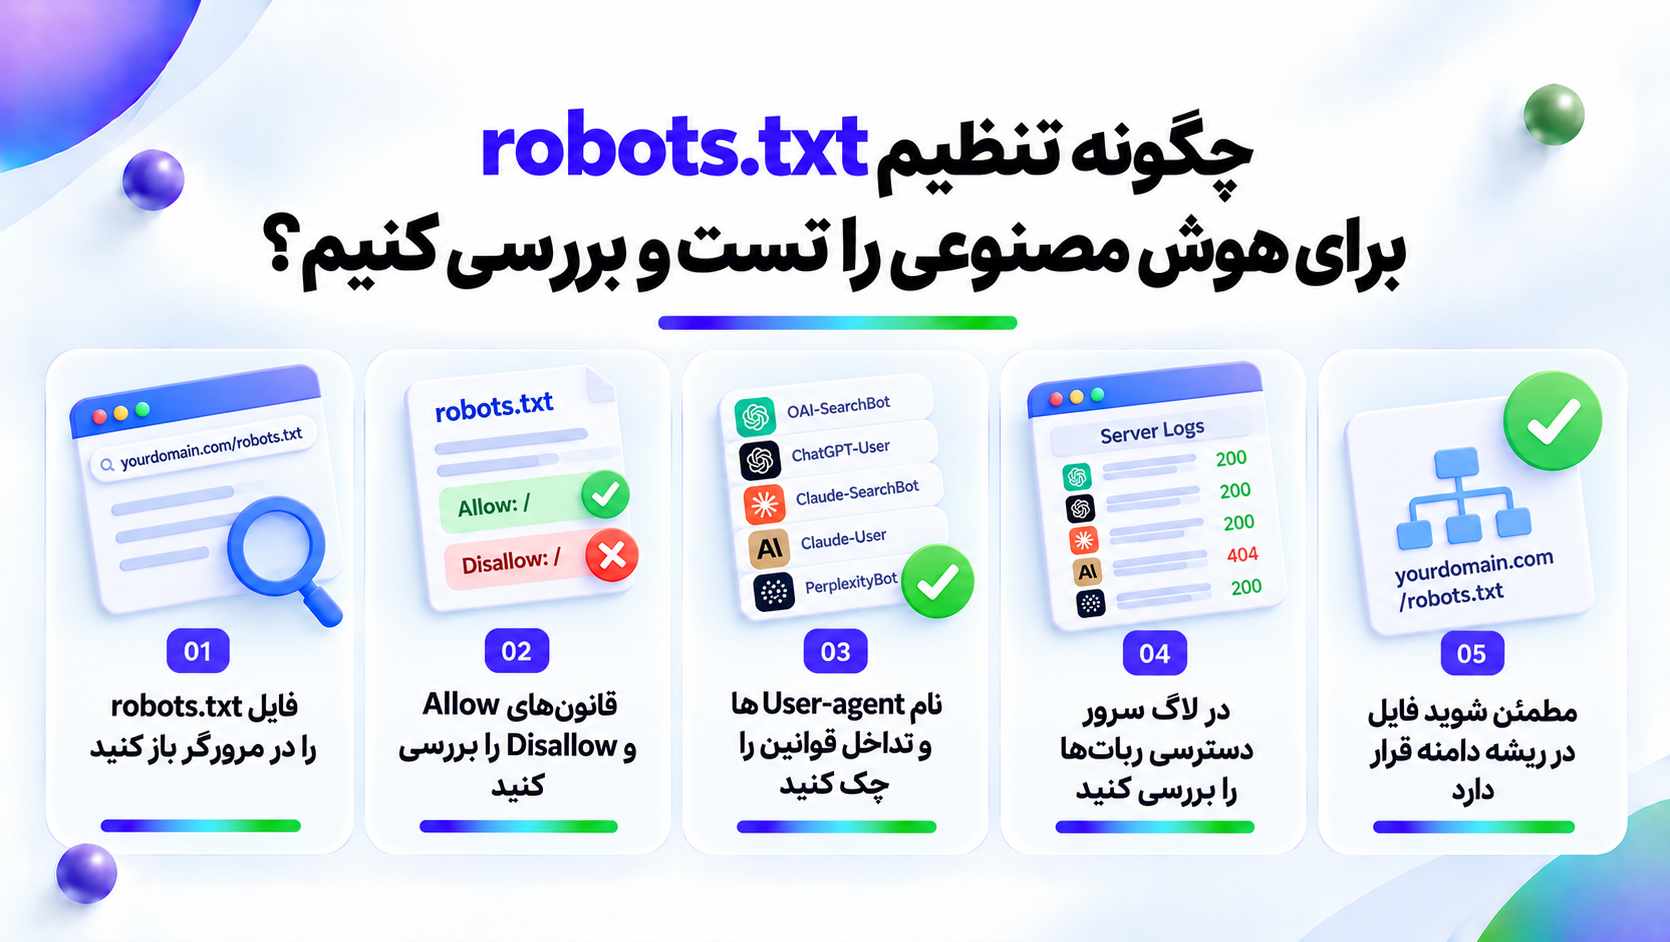
بعد از هر تغییر در فایل robots.txt، حتماً آن را بهصورت عملی تست کنید، نه فقط با خواندن محتوای فایل.
کافی است آدرس yourdomain.com/robots.txt را مستقیم در مرورگر باز کنید و ببینید بلوک مربوط به همان User-agent چه قانونی دارد. اگر لاگ سرور هم در دسترستان است، میتوانید مستقیماً ببینید آیا درخواستهای آن ربات بعد از تغییر robots.txt کاهش پیدا کرده یا نه.
تنها راه مطمئن، بررسی لاگ سرور است، نه فقط خواندن فایل robots.txt. در لاگ سرور میبینید کدام User-agent واقعاً درخواست زده و پاسخ سرور چه بوده؛ این تنها روشی است که نشان میدهد ربات علاوه بر خواندن قانون، واقعاً آن را هم رعایت کرده یا نه.
اگر نمیدانید دقیقاً کدام رباتها الان به محتوای شما دسترسی دارند، آنالیز سئو سایت میتواند تصویر روشنی از وضعیت فعلی بدهد.
سخن آخر
تنظیم robots.txt برای هوش مصنوعی یعنی تصمیم گرفتن دربارهی دو گروه ربات، نه یک انتخاب کلی. رباتهای جستجوی زنده مثل OAI-SearchBot و Claude-SearchBot تعیین میکنند سایتتان در پاسخهای هوش مصنوعی دیده شود یا نه، و رباتهای آموزشی مثل GPTBot و Google-Extended فقط به استفاده از محتوا برای آموزش مدلها مربوطاند.
برای بیشتر سایتها، بهترین مسیر این است که گروه اول باز بماند و دربارهی گروه دوم بر اساس ارزش محتوایتان تصمیم بگیرید. بعد از هر تغییر فایل را بررسی کنید و برای محتوای حساس به robots.txt اکتفا نکنید.
اگر میخواهید این تنظیمات را با اطمینان انجام دهید،منتورینگ سئو یا یک جلسه مشاوره سئو سایت میتواند کمک کند.
سوالات متداول
بله، مستقیماً. اگر OAI-SearchBot و ChatGPT-User در robots.txt مسدود باشند، سایت شما در پاسخهای ChatGPT بهعنوان منبع نمایش داده نمیشود.
نه لزوماً. GPTBot فقط برای آموزش مدل است؛ نمایش در پاسخهای زندهی ChatGPT به OAI-SearchBot و ChatGPT-User بستگی دارد، نه GPTBot.
خیر، دو User-agent کاملاً جدا از هم با وظایف متفاوتاند؛ یکی برای آموزش مدل و دیگری برای جستجوی زندهی ChatGPT Search.
خیر. Google-Extended فقط مربوط به استفادهی محتوا در آموزش Gemini است و هیچ ارتباطی با رتبه یا ایندکس شدن در جستجوی عادی گوگل ندارد.
تا حدی، و فقط برای رباتهایی که این توافق را رعایت میکنند. مسدود کردن GPTBot یا ClaudeBot معمولاً مانع استفادهی رسمی آن شرکت از محتوای شما برای آموزش میشود، اما تضمین صددرصدی نیست.
نه، نیازی به فایل جداگانه نیست. کافی است در همان فایل robots.txt اصلی، برای هر ربات هوش مصنوعی یک بلوک User-agent مستقل اضافه کنید.
بستگی به سرعت خزش هر ربات دارد؛ معمولاً بین چند ساعت تا چند روز طول میکشد تا رباتهای مختلف نسخهی جدید فایل را دوباره بخوانند و طبق آن رفتار کنند.